
تأسيس أول مختبر بحثي مشترك للجامعات في آسيا... توسيع النظام البيئي العالمي للذكاء الاصطناعي انطلاقاً من اللغة الكورية
القدرات البحثية الكورية في مجال الذكاء الاصطناعي تحظى باهتمام عالمي... الكشف عن نتائج البحث الأولى في النصف الثاني من العام القادم
اختارت شركة إنفيديا اللغة الكورية منطلقاً أساسياً لتطوير تقنيات تعلم الذكاء الاصطناعي على المستوى العالمي. تتضمن الخطة توليد وتعلم بيانات اللغة الكورية، ثم توسيع هذه التقنيات لتشمل دول ولغات أخرى. يُفسَّر هذا التوجه بأنه محاولة من إنفيديا الاستفادة من الجدارة التكنولوجية العالمية لكوريا الجنوبية لتعزيز نفوذها في النظام البيئي العالمي للذكاء الاصطناعي. غير أن الشركة قدّمت تفسيرات نظرية بشأن الفوائد التجارية المحددة التي ستحققها من خلال بحوث اللغة الكورية، مركزة على بناء نظام بيئي منفتح للذكاء الاصطناعي.
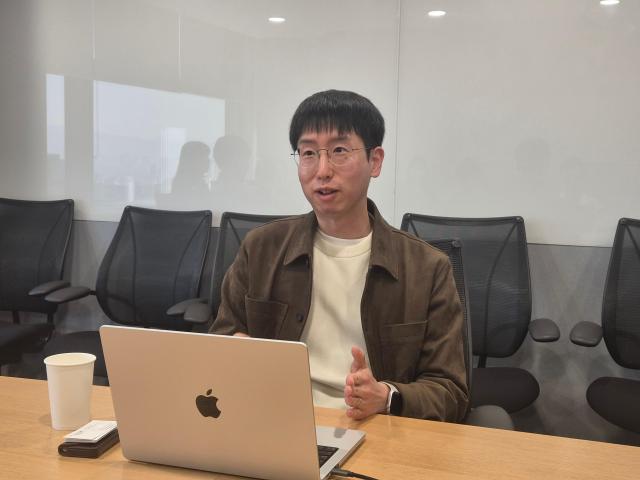
قال كيم هيون-وو، مدير البحث العلمي بشركة إنفيديا ومدير المختبر البحثي المشترك بين إنفيديا والمعهد الكوري للعلوم والتكنولوجيا (كايست)، في ندوة صحفية عقدت في مقر إنفيديا كوريا بمنطقة كانغنام في سيول في العاشر من الشهر الحالي: "معهد كايست أصبح مؤسسة تحظى باهتمام عالمي استثنائي"، موضحاً خلفية تأسيس المختبر البحثي المشترك في كوريا الجنوبية.
أضاف المدير: "التحصيل البحثي المتميز لمعهد كايست يتزامن مع الموقع الفريد للغة الكورية كلغة متوسطة الموارد"، وأردف: "مع إضافة الاهتمام العالي للكوريين بالذكاء الاصطناعي، تشكّلت فرصة ذهبية."
تكمن قيمة اللغة الكورية التي تركز عليها إنفيديا في أنها أساس بحثي قابل للتوسع إلى أسواق الذكاء الاصطناعي العالمية. اللغة الكورية لا تتمتع بموارد تعلم غنية كما اللغة الإنجليزية أو الصينية، لكنها تندرج ضمن فئة "اللغات متوسطة الموارد"، حيث توجد بيانات أكثر من اللغات الأقلية. يُعتبر هذا شرطاً مفيداً لتطوير والتحقق من تقنيات تعلم البيانات الجديدة.
قال كيم هيون-وو: "الهدف هو الكشف عن طرق تعلم البيانات التي تبدأ من اللغة الكورية وتنطبق على لغات أخرى"، ومتابعاً: "لا نسعى لزراعة شجرة جيدة واحدة، بل نبحث عن طرق لإنشاء غابة وتشاركها مع العالم."
عندما سُئل عن الفوائد التجارية المحددة التي سيجنيها هذا البحث في اللغة الكورية لشركة إنفيديا، لم يقدم نموذجاً إيرادياً محدداً. أجاب: "على مستوى الشركة، نحلم بنظام بيئي منفتح للذكاء الاصطناعي"، و"الهدف هو البحث عن منهجيات يمكن للعالم بأسره استخدامها، بدءاً من اللغة الكورية، لتمكين كل دولة من بناء ذكاء اصطناعي بلغتها الخاصة."
أعلنت إنفيديا والمعهد الكوري للعلوم والتكنولوجيا (كايست) في يوليو الماضي عن تأسيس المختبر البحثي المشترك، وهو أول مختبر بحثي مشترك للذكاء الاصطناعي تؤسسه إنفيديا مع جامعة في آسيا. يخطط الطرفان لتنفيذ تعاون بقيمة إجمالية قدرها 300 مليون دولار (حوالي 400 مليار وون) على مدى السنوات الخمس القادمة. سيتم توفير 250 مليون دولار كموارد حاسوبية، بينما تجري مناقشات حول طرق تخصيص باقي الموارد.
قال كيم هيون-وو: "هناك أهمية في أن شركة عملاقة عالمية في مجال الذكاء الاصطناعي تؤسس مختبراً بحثياً في بلادنا وتوظف باحثين"، مضيفاً: "أرغب في إظهار القدرات المتميزة للباحثين الكوريين، وتشجيع المزيد من الشركات العالمية على إنشاء مختبرات بحثية محلية."
ترك المجال مفتوحاً أمام احتمالية توسيع التعاون ليشمل جامعات أخرى. قال: "الهدف هو أن نتمكن من فتح ما نحققه من نتائج"، مشيراً إلى أنه "لا حاجة لقصر الأمر على إنفيديا وحدها. ستتمكن شركات أخرى أيضاً من رؤية القدرات الكورية والعمل على الدخول إلى السوق."
أوضح أن طبيعة التعاون مع جامعة سيول مختلفة. مركز تقنيات الذكاء الاصطناعي من إنفيديا (NVAITC) مع جامعة سيول يركز على البحث المشترك والتعليم. بينما يقوم المختبر البحثي المشترك مع كايست بتوظيف باحثين دوام كامل من إنفيديا وتوفير موارد حاسوبية.
تشغيل المختبر البحثي لا يزال في مرحلة مبكرة. قال كيم هيون-وو: "بدأنا في توظيف الباحثين، ونخطط لتوظيف عدة أشخاص قبل نهاية العام الحالي." جارية حالياً مفاوضات مع شركاء السحابة الحاسوبية المحليين من إنفيديا لتأمين موارد وحدات معالجة الرسومات (GPU)، لكن العدد المحدد للمعدات لم يُحدَّد بعد.
طُرحت أسئلة حول ما إذا كان يمكن الاستمرار في تشغيل المختبر البحثي في حالة تغيير الرئيس التنفيذي (CEO) للشركة في ضوء المشاكل القيادية الأخيرة بإنفيديا. أجاب كيم هيون-وو: "أعتقد أنني لست الشخص المناسب للحديث عن هذه النقطة"، لكنه أضاف: "كمدير للمختبر، الهدف هو إكمال المهام الموكلة إليّ بدون عوائق."
تتمحور المهمة الأساسية للمختبر البحثي المشترك حول حل مشكلة نقص بيانات تعلم اللغة الكورية. وفقاً لمواد المعلومات المقدمة، فإن الوثائق باللغة الكورية في مجموعة البيانات متعددة اللغات mC4 تبلغ حوالي 24 مليون وثيقة، وهو ما يعادل 1/163 من عدد الوثائق باللغة الإنجليزية البالغة 3.93 مليار وثيقة.
قال كيم هيون-وو: "من الصعب جداً العثور على مجموعات بيانات عالية الجودة ومفتوحة باللغة الكورية"، مشيراً إلى أن "النقص يمتد عبر جميع المجالات، وليس مجالاً محدداً وحسب." أضاف: "من الصعب تضييق الفجوة بالاعتماد على البيانات المُولّدة من البشر وحدهم"، وأوضح أن المختبر سيركز على البحث في إنشاء بيانات اصطناعية وتقنيات تعلم البيانات الموجودة بكفاءة أكبر.
تظهر نتائج واضحة بالفعل. مجموعة البيانات الاصطناعية باللغة الكورية "نيموترون بيرسونا كوريا" التي كشف عنها كيم هيون-وو سابقاً احتلت المركز الأول في قائمة مجموعات البيانات الشهيرة عالمياً على منصة هاجينج فيس لمدة عشرة أيام. كما سُجّل حوالي 140,000 عملية تحميل.
ظهرت حالات استخدام من قبل شركات كورية محلية أيضاً. قال كيم هيون-وو: "مجموعة البيانات هذه تم استخدامها في 'كي-إكسافان 2.5' التي كشفت عنها معهد بحوث الذكاء الاصطناعي بـ إل جي أمس"، معتبراً إياها "حالة من التفاعل الإيجابي للنظام البيئي، حيث يستفيد كل طرف من إنجازات الآخر لبناء نماذج أفضل."
تُعتبر مسائل الملكية الفكرية المتعلقة باستخدام البيانات الاصطناعية أيضاً من بين مجالات البحث الأساسية. أوضح كيم هيون-وو أنه من المستحيل معرفة الطريقة التي حصل بها نموذج الذكاء الاصطناعي الموجود على البيانات الأصلية. سيركز المختبر البحثي على الطريقة التي تستخدم المعرفة من النماذج المتعلمة بالفعل لإنشاء بيانات جديدة.
يتم دفع نتائج البحث نحو الكشف العام بحيث لا تحتكرها شركة واحدة. قال كيم هيون-وو: "كشفنا عن مجموعة بيانات نيموترون بيرسونا بطريقة يمكن استخدامها تجارياً"، مشيراً إلى أنه "سيتم تطوير بيانات وطرق تعلم يمكن لشركات أخرى أيضاً الاستفادة منها."
يُتوقع الكشف عن النتائج البحثية الأولى في النصف الثاني من العام القادم. قال كيم هيون-وو: "هناك مشاريع مثيرة للاهتمام جاهزة، وقد يتم الكشف عنها في حوالي النصف الثاني من العام المقبل"، مختتماً بـ "سنسعى لضمان أن البحث الذي بدأ من بلادنا يساهم في النظام البيئي العالمي للذكاء الاصطناعي."
* تمت ترجمة هذا المقال تلقائيًا بواسطة الذكاء الاصطناعي.