
نماذج «أوبن إيه آي» و«جوجل» الأفضل عالميًا تحقق النقاط الكاملة، وتتبعها نماذج صينية
نموذج «كيه-إكسا وون 2.5» من معهد إل جي للذكاء الاصطناعي يسجل أفضل أداء محلية
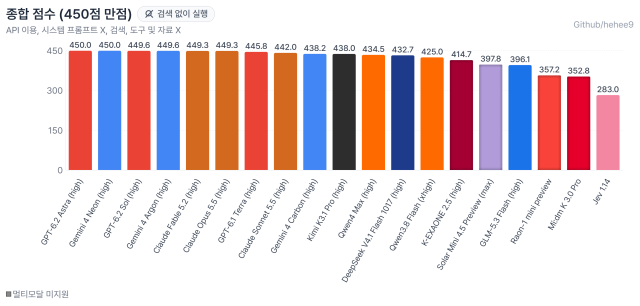
بعد انتهاء امتحان القدرات للعام الدراسي 2027، أظهرت النتائج أن نماذج الذكاء الاصطناعي من الولايات المتحدة والصين وكوريا الجنوبية حققت درجات متفاوتة. فقد حقق نموذجا «أوبن إيه آي» و«جوجل» النقاط الكاملة وهي 450 درجة.
بينما حصل نموذج معهد إل جي للذكاء الاصطناعي وشركة «أب ستيج» المشاركة في مشروع نموذج الأساس الذاتي الذي تدفعه وزارة العلوم والتكنولوجيا وتكنولوجيا المعلومات على درجات أقل نسبيًا. وأظهرت النتائج بشكل خاص تراجعًا حادًا في المسائل التي تتضمن صور، مما يدل على أن أداة معالجة متعددة الأنماط لدى النماذج الكورية تتخلف عن أفضل النماذج العالمية.
في 20 تشرين الثاني (نوفمبر)، كشف قو يو-جيم من قسم هندسة البرمجيات بجامعة سونتشون هيانغ عن «لوحة معلومات حل النماذج اللغوية الكبيرة لامتحان القدرات للعام الدراسي 2027».
وفقًا للوحة المعلومات، حقق نموذجا «جي بي تي-6.2 أسترا» من «أوبن إيه آي» و«جيميناي 4 نيون» من «جوجل» النقاط الكاملة في امتحان القدرات 2027.
وأظهرت نماذج «أنثروبيك» أيضًا أداءً قويًا. فقد حقق كل من «كلود فيبل 5.2» و«كلود أوبس 5.5» درجة 449.3 نقطة. كما حقق نموذج «جي بي تي 6.1 تيرا» من «أوبن إيه آي» درجة 445.8 نقطة.
وحققت النماذج الصينية أيضًا درجات عالية. حصل نموذج «كي 3.1 برو» من شركة الذكاء الاصطناعي الصينية «كيمي» على 438 درجة. وحققت «كيمي» درجات كاملة في مواد اللغة الكورية والإنجليزية والتاريخ الكوري، لكنها حصلت على 96 درجة في الرياضيات و92 درجة في الاختبارات الاستكشافية.
وحقق نموذج «كيوين 4 ماكس» من مجموعة «علي بابا» الصينية أيضًا 100 درجة في مواد اللغة الكورية والإنجليزية والتاريخ الكوري. بينما حصل على 96 درجة في الرياضيات و88.5 درجة في الاختبارات الاستكشافية.
وعلى النقيض من ذلك، أظهرت النماذج المحلية فجوة كبيرة في الدرجات مقارنة بأفضل النماذج العالمية. حقق نموذج «كيه-إكسا وون 2.5» من معهد إل جي للذكاء الاصطناعي إجمالي 414.7 درجة، وهي أقل بـ 35.3 درجة من نموذج «أسترا» من «أوبن إيه آي». حقق النموذج درجات كاملة في الرياضيات والتاريخ الكوري، لكنه حصل على 98 درجة في اللغة الكورية و96 درجة في اللغة الإنجليزية و70.7 درجة فقط في الاختبارات الاستكشافية.
وحقق نموذج «سولا ميني 4.5 بريفيو» من شركة «أب ستيج» درجة 397.8 نقطة، أي بفارق 52.2 درجة عن النموذج الذي حقق النقاط الكاملة. حقق النموذج درجات كاملة في مادة التاريخ الكوري فقط، وحصل على 91 درجة في اللغة الكورية و95.7 درجة في الرياضيات و96 درجة في اللغة الإنجليزية و65.2 درجة في الاختبارات الاستكشافية.
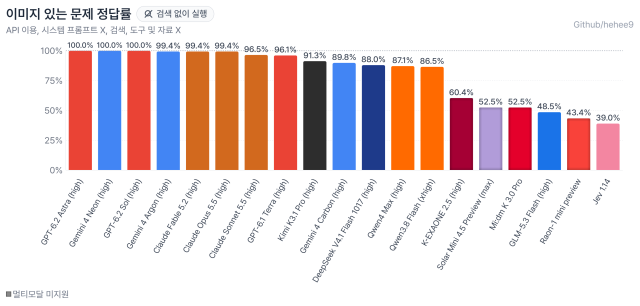
وأظهرت النماذج المحلية بشكل خاص معدلات إجابة منخفضة في المسائل التي تتضمن صورًا. حقق نموذجا «جي بي تي-6.2 أسترا» و«جيميناي 4 نيون» و«جي بي تي-6.2 سول» معدل إجابة صحيحة بنسبة 100 بالمئة للمسائل التي تتضمن صورًا. وحقق نموذجا «كلود فيبل 5.2» و«كلود أوبس 5.5» أيضًا معدلات 99.4 بالمئة على التوالي.
بينما بلغ معدل الإجابات الصحيحة للمسائل التي تتضمن صورًا في نموذج «كيه-إكسا وون 2.5» نسبة 60.4 بالمئة فقط. وحقق نموذج «سولا ميني 4.5 بريفيو» معدل 52.5 بالمئة. وهذا يمثل انخفاضًا بـ 39.6 نقطة مئوية و47.5 نقطة مئوية على التوالي مقارنة بنموذج «أسترا».
يرى الخبراء أن الفجوة في أداء النماذج تنشأ من عوامل معقدة تشمل بيانات التدريب وحجم النموذج وقدرات الاستدلال. وقال البروفيسور تشو بيونغ-هو من معهد الذكاء الاصطناعي بجامعة كوريو: «هناك فرق كبير في حجم المعاملات بين نماذج شركات التكنولوجيا الكبرى العالمية والشركات المحلية، وكذلك في مستوى البنية التحتية الحوسوبية المتاحة في مراحل الاستدلال. المسائل التي تتضمن صورًا تتطلب استخراج المعلومات بدقة باستخدام تقنية التعرف البصري على الأحرف، ثم إجراء الاستدلال. وبما أن شركات التكنولوجيا الكبرى قد عززت أداء نماذج الاستدلال بشكل كبير، فلا بد من وجود فرق في النتائج».
وأضاف: «يعتبر الفرق في بيانات التدريب عاملاً مهمًا أيضًا. فقد تكون شركات التكنولوجيا الكبرى العالمية قد درّبت نماذجها مسبقًا على أسئلة امتحان القدرات السابقة ومجموعات الأسئلة، لكن الشركات المحلية قد لا تكون قد وفرت هذه البيانات ذات الصلة بشكل كافٍ».
* تمت ترجمة هذا المقال تلقائيًا بواسطة الذكاء الاصطناعي.